OtterSR 如何工作
完整流程:从一个文献文件到一篇写成的综述。
目前还没有演示视频。下面是真实应用的截图,每次发布时都会基于预置的演示综述重新生成,因此这里没有任何一张是效果图。
导入你的文献
拖入 RIS、NBIB、PubMed 或 CSV 文件,OtterSR 会读取它,推断每一列对应什么,并在保存任何内容之前先向你展示结果。如果推断有误,你可以修正映射。你还可以在应用内直接检索 PubMed、Europe PMC、Crossref、OpenAlex 和 ClinicalTrials.gov,并把结果收集到同一个文献库中。
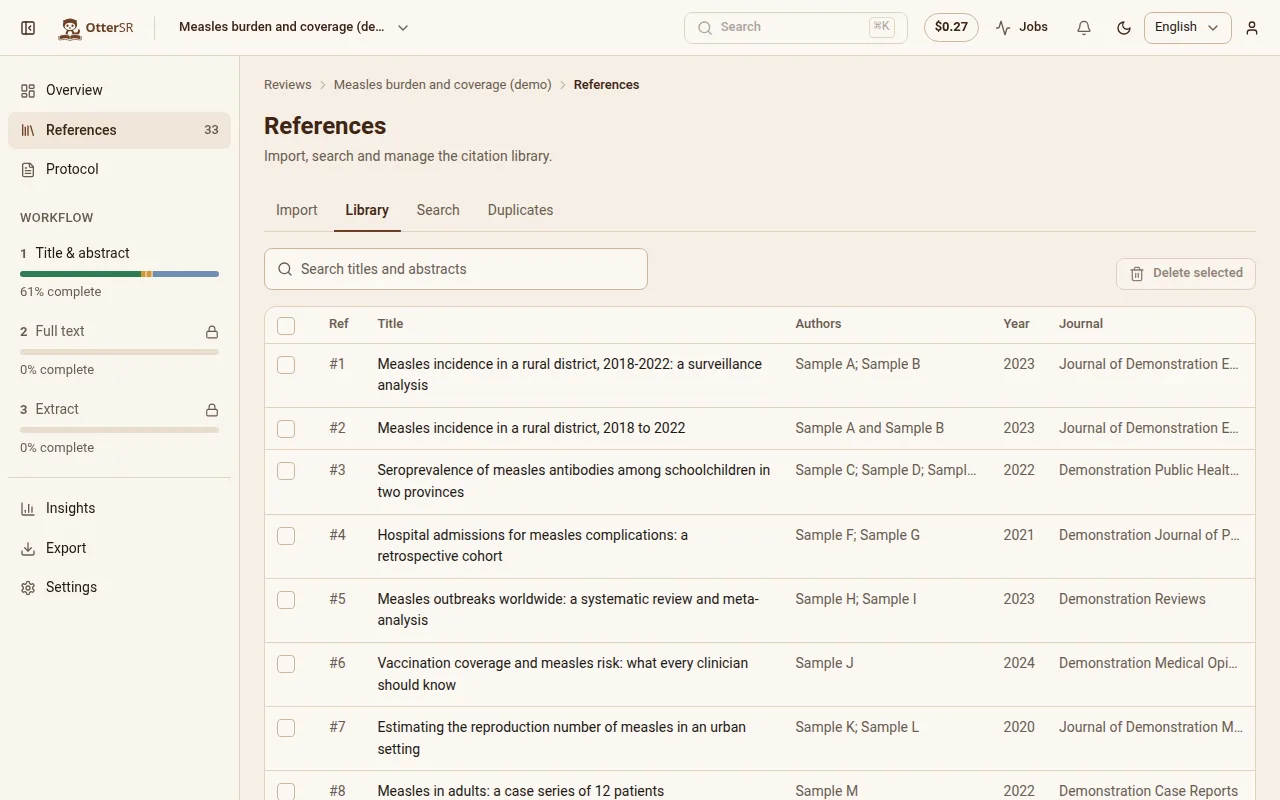
导入不收取任何费用,无论文件多大;在你确认之前不会写入任何内容。
在重复文献产生费用之前先处理它们
同一项研究从三个数据库导入,标题略有差异。OtterSR 会把候选文献分组,逐字段并排展示各条记录,并建议保留哪一条——信息最完整的那条。你用键盘确认即可。
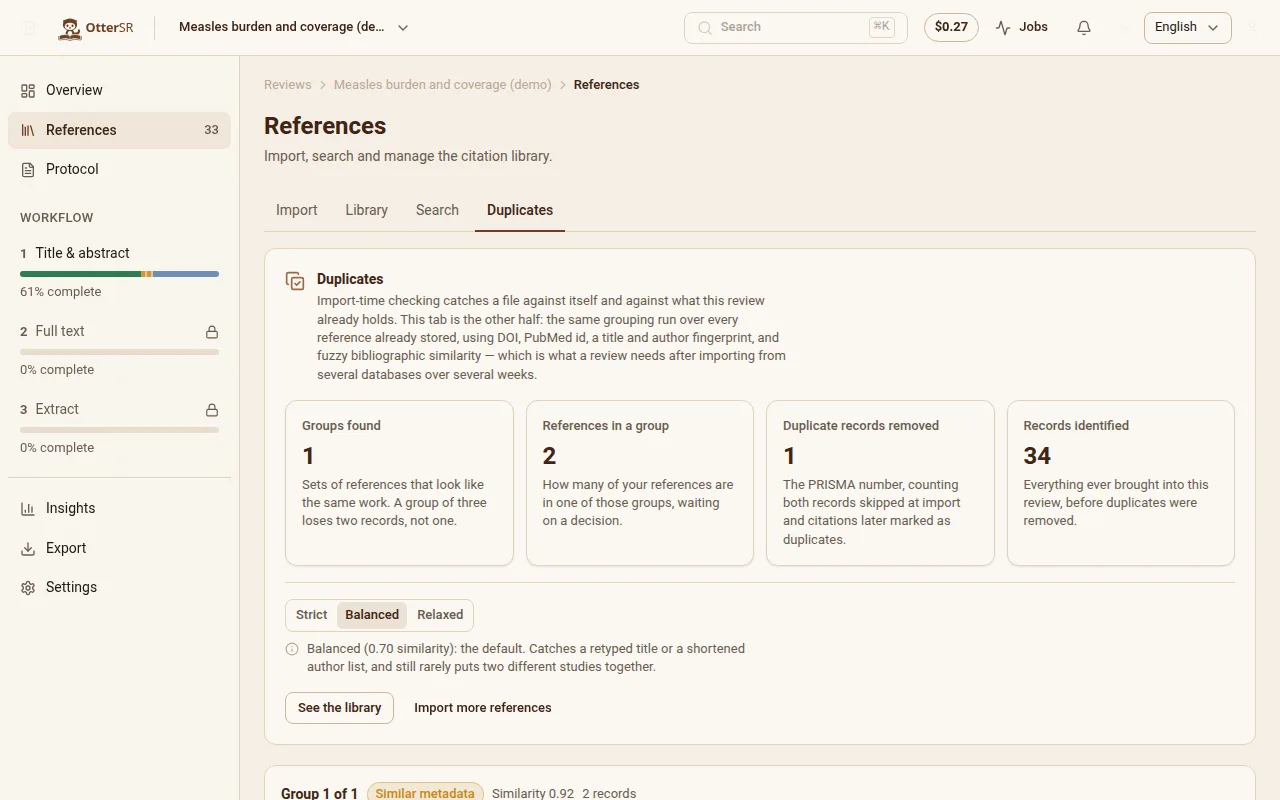
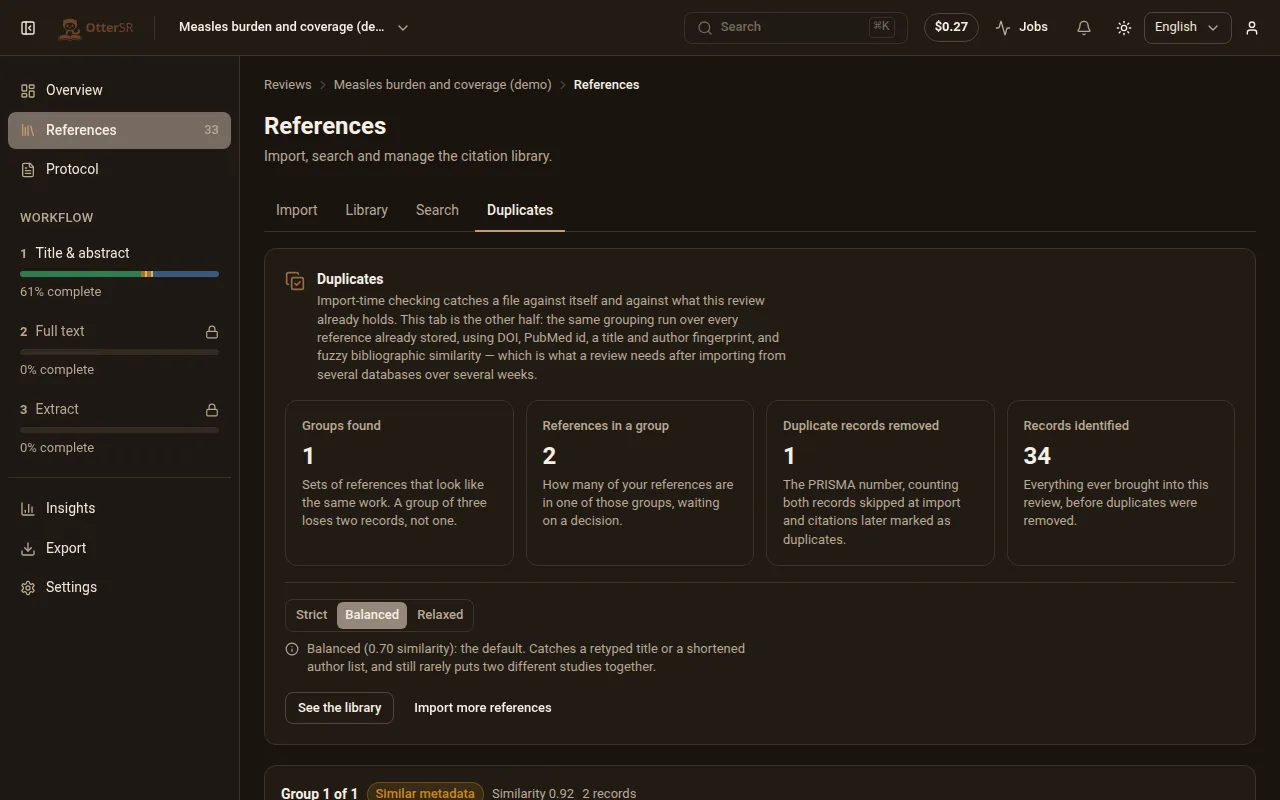
移除是软删除,因此被移除的重复文献在 PRISMA 流程图中仍计为“已识别、后移除”,并且可以撤销。移除重复文献绝不会提高完成百分比。
编写方案
每个筛选问题都有自己的答案选项,每个选项都标记为纳入、排除或中立,这样软件就能明确知道每个答案的含义,而不是从措辞中猜测。你可以用自己的话为边界情况添加说明。方案带有版本:修改方案会创建新版本,绝不会悄悄改写已经做出的决定。
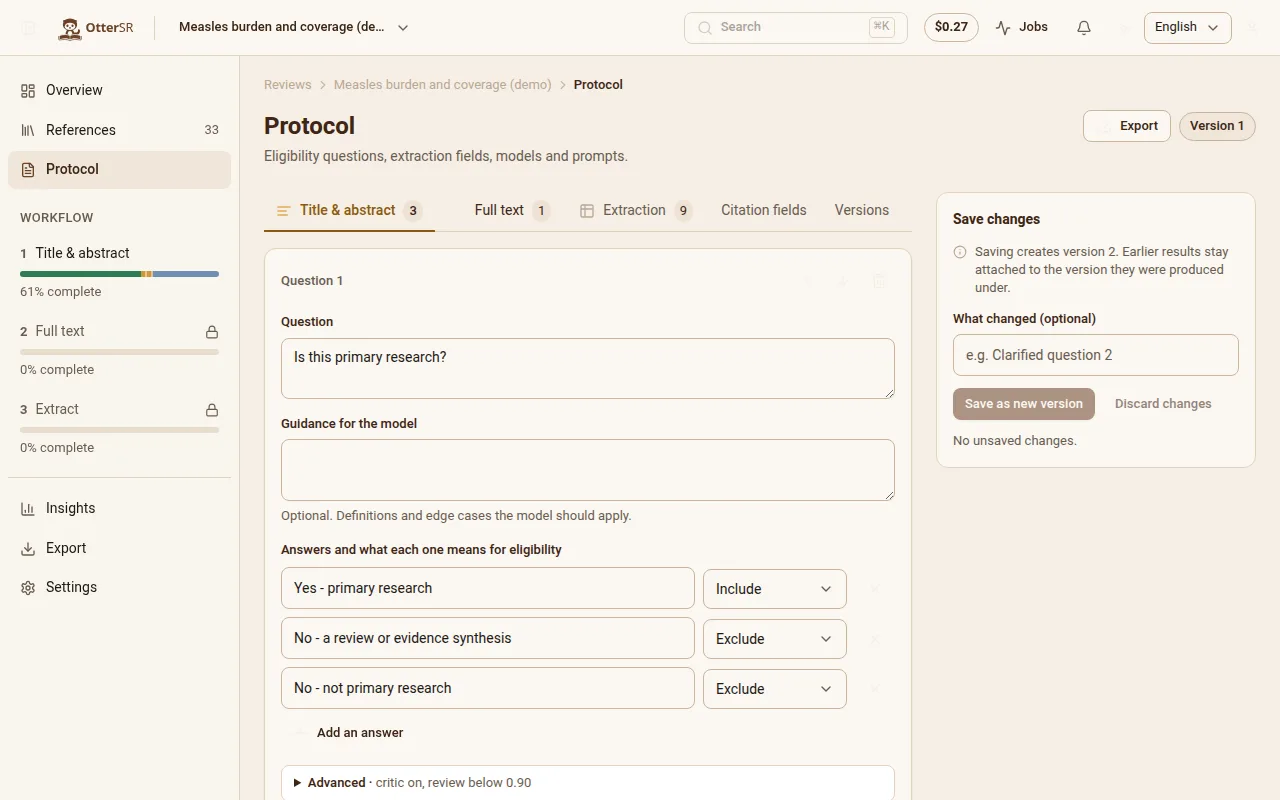
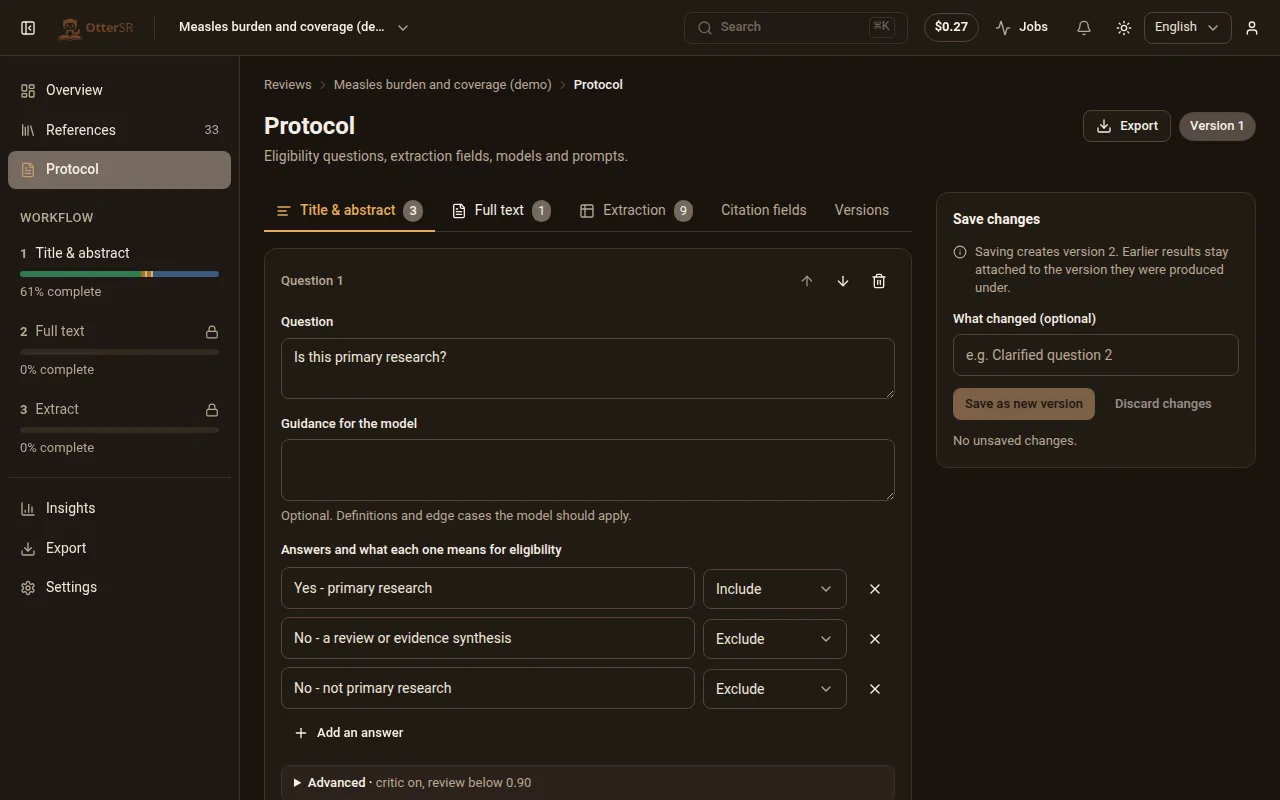
可以从模板开始、导入同事的方案文件,或自己编写。文件格式是纯 YAML,导出再导入后逐字节保持不变。
让 AI 先来
筛选以后台任务的形式运行,你可以查看、暂停和取消。每个回答都附带置信度分数和它所依据的句子。低于你设定的置信度阈值的回答会排队等待人工处理;复核 AI 会重新阅读不确定的回答,并标出它不同意的地方。
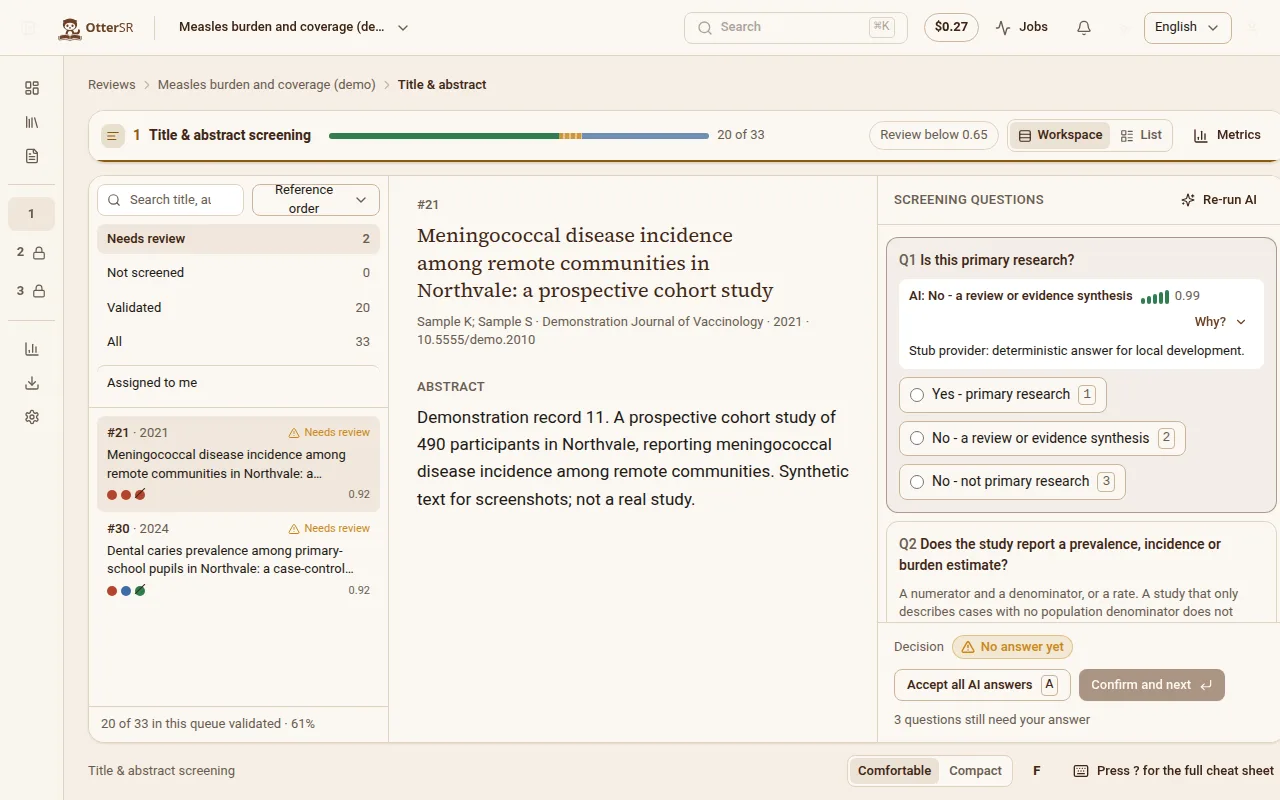
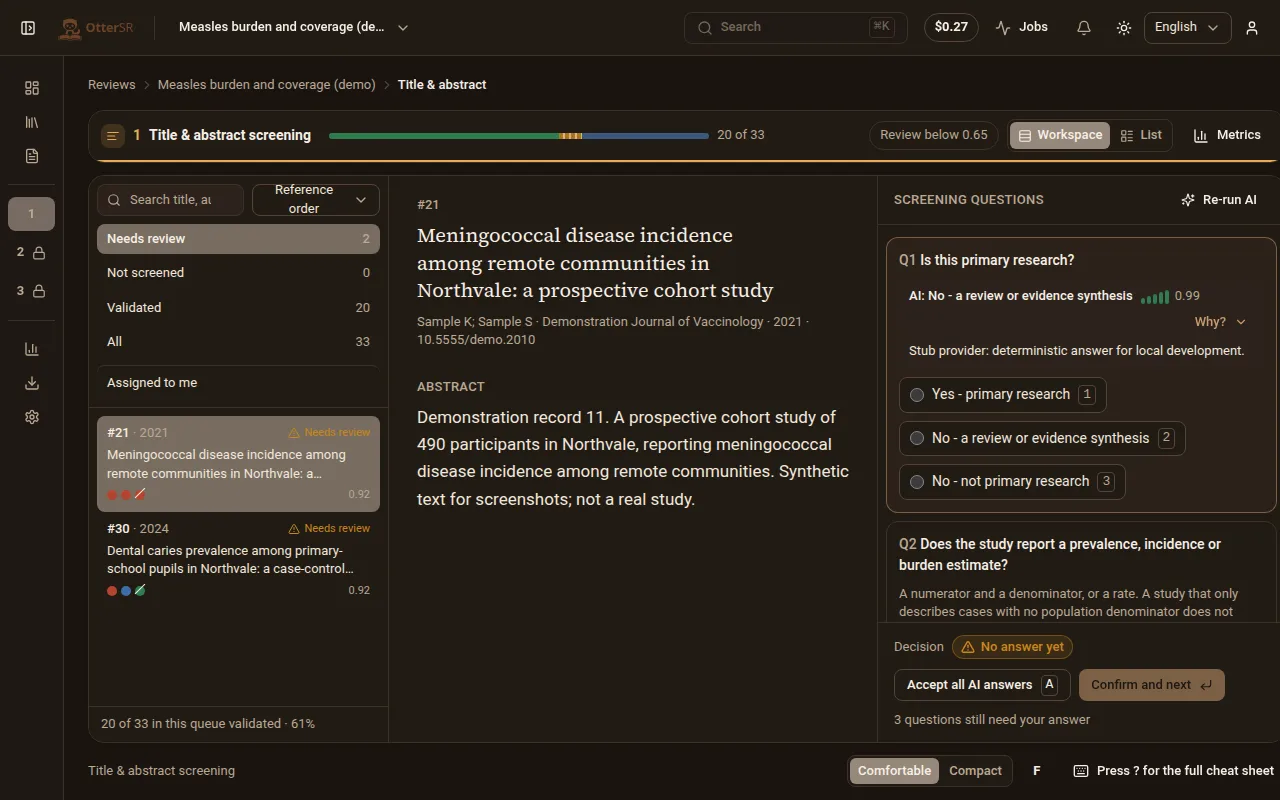
AI 绝不会替你填写答案。接受它只需按一个键,但按键的是你——除非你为一条已经测试过的规则主动开启自动接受。
看看它是否值得信任
随着你核验决定,OtterSR 会以你自己的工作为基准衡量一致率、敏感度和校准情况,并在每个数字旁显示样本量。置信度阈值控件就放在这些证据旁边:拖动它,你就能看到能节省多少工作量,以及会漏掉多少应纳入的文献。
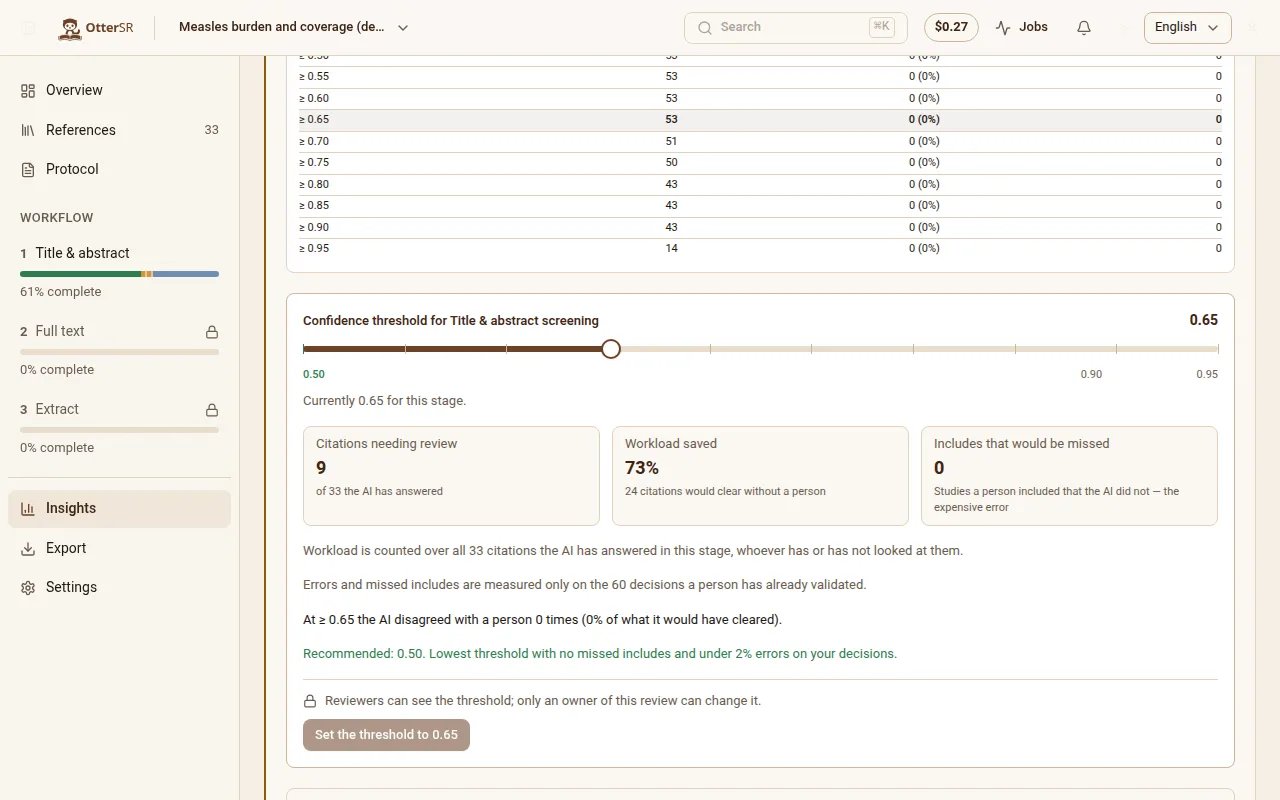
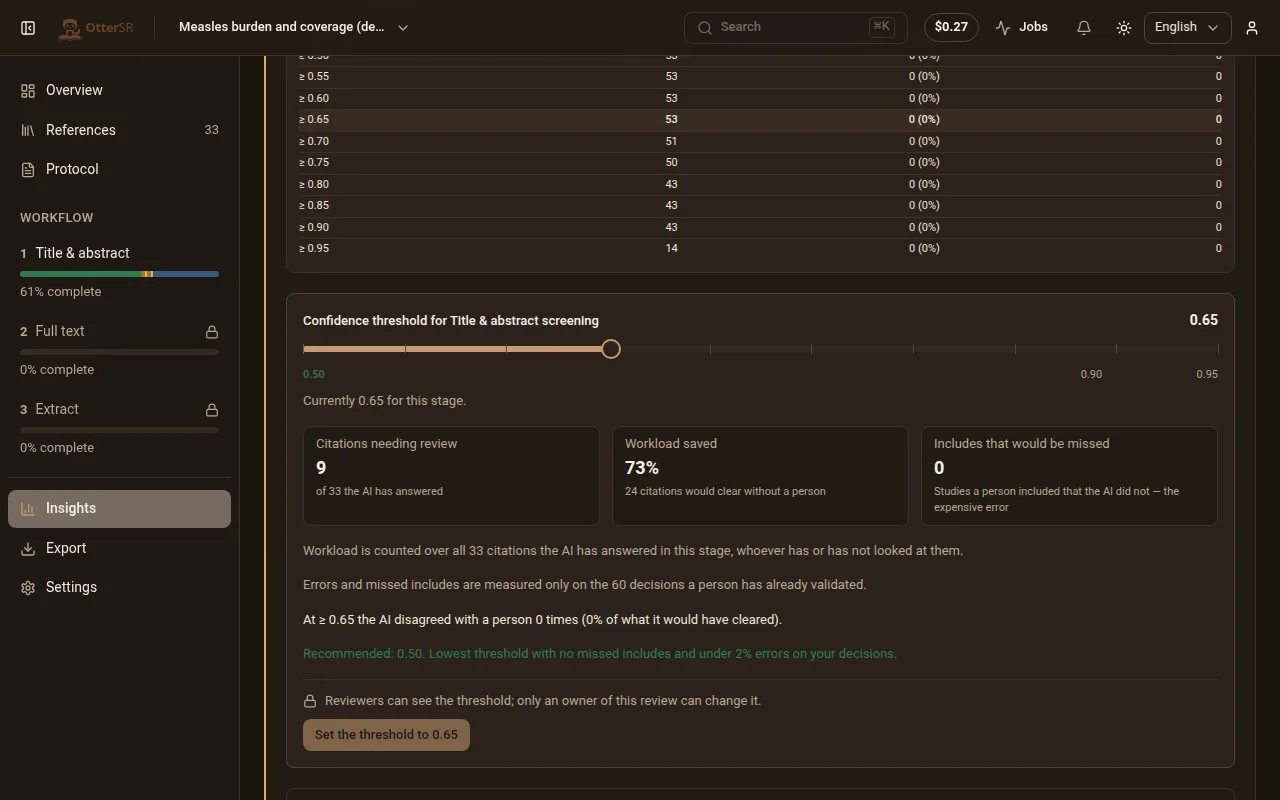
样本量不足以得出有意义的结论时,应用会直接说明,而不是硬给出一个数字。更改阈值只会重新排序队列,绝不会改动人做出的任何决定。
进入全文阶段
你纳入的文献会进入全文筛选。上传 PDF 后,文本会被提取出来,使回答能够引用某一页上的段落。概览页保持一份实时更新的 PRISMA 流程:已识别、已去重、已筛选、已尝试获取、已评估、已排除(附原因)、已纳入。
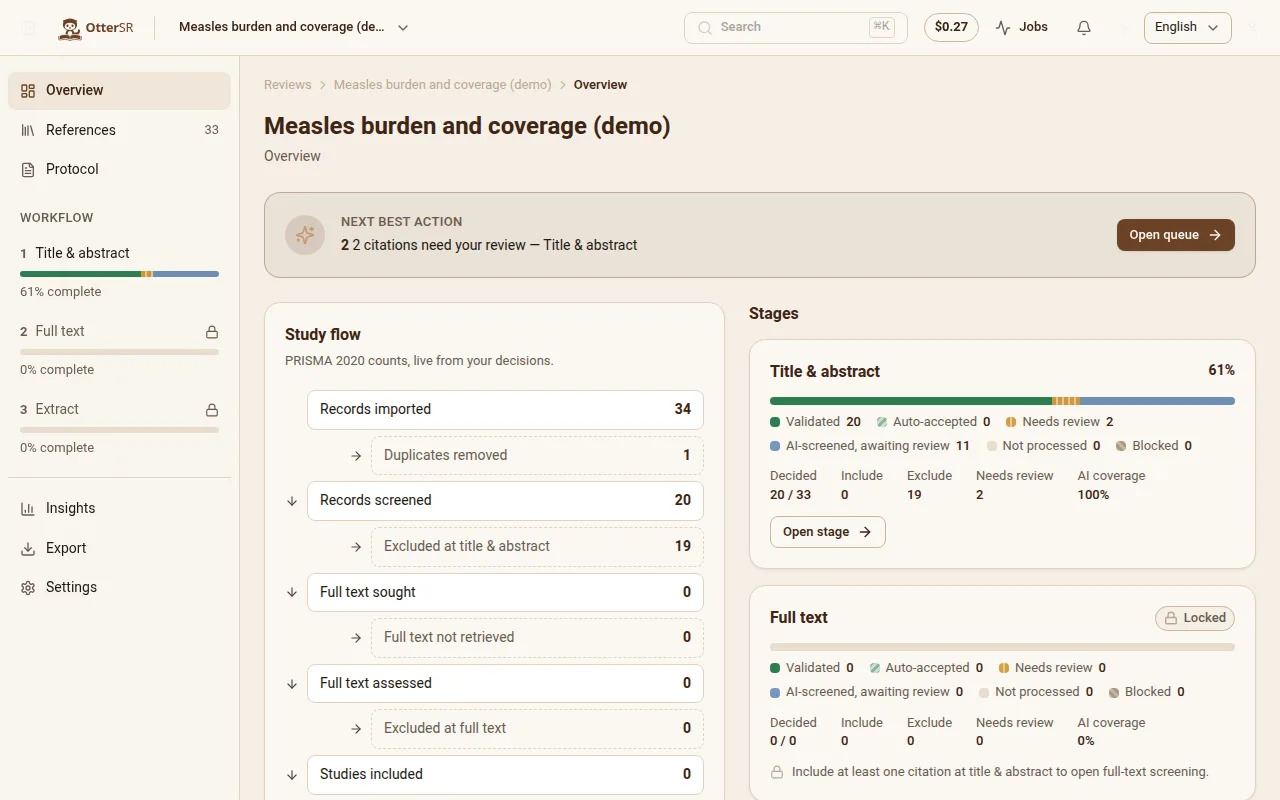
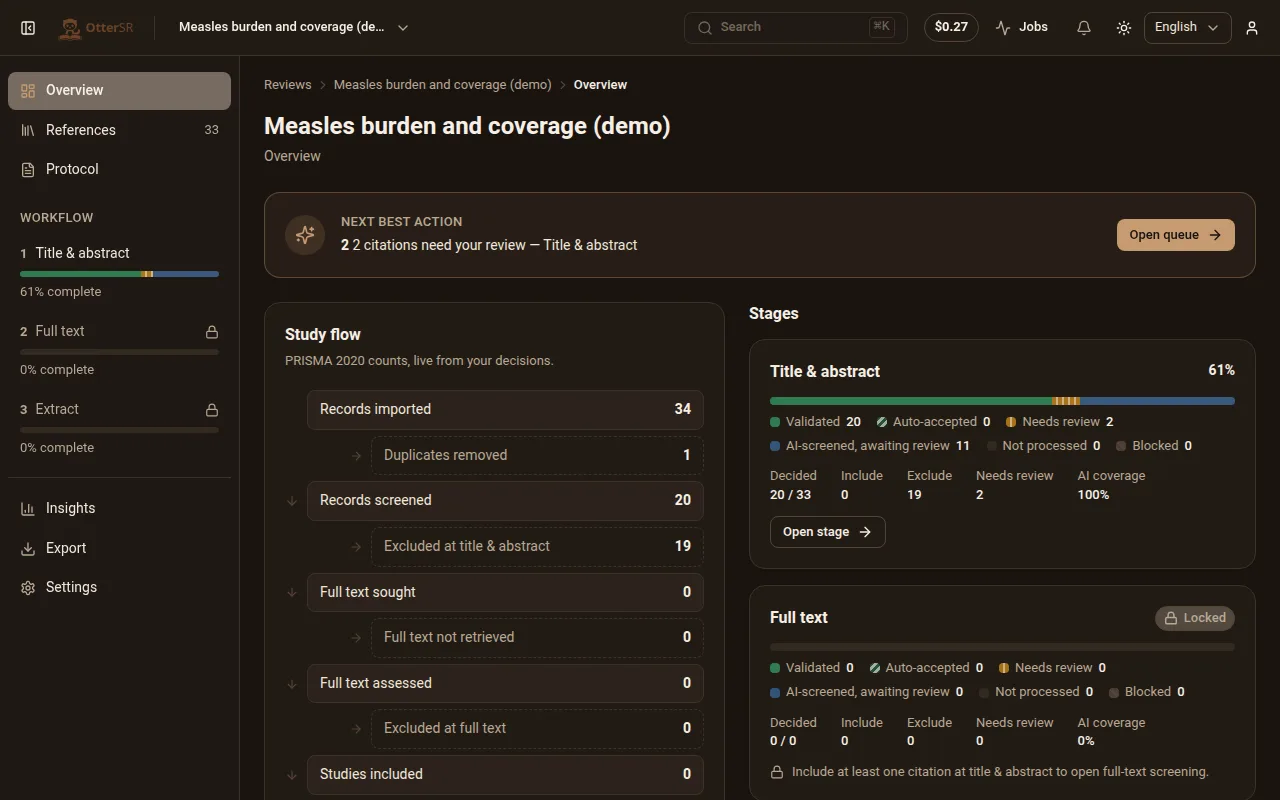
没有 PDF 的文献会显示为受阻并附原因,而不是被悄悄跳过。
提取,然后导出
定义你需要的字段——研究人群、研究设计、结局、效应量——AI 会提出各字段的值,并附上每个值的出处段落。结果可导出为 CSV、Excel、RIS 或 R 数据集,同时附带一张数字与导出内容一致的 PRISMA 流程图,以及一段描述实际操作过程的方法学段落。
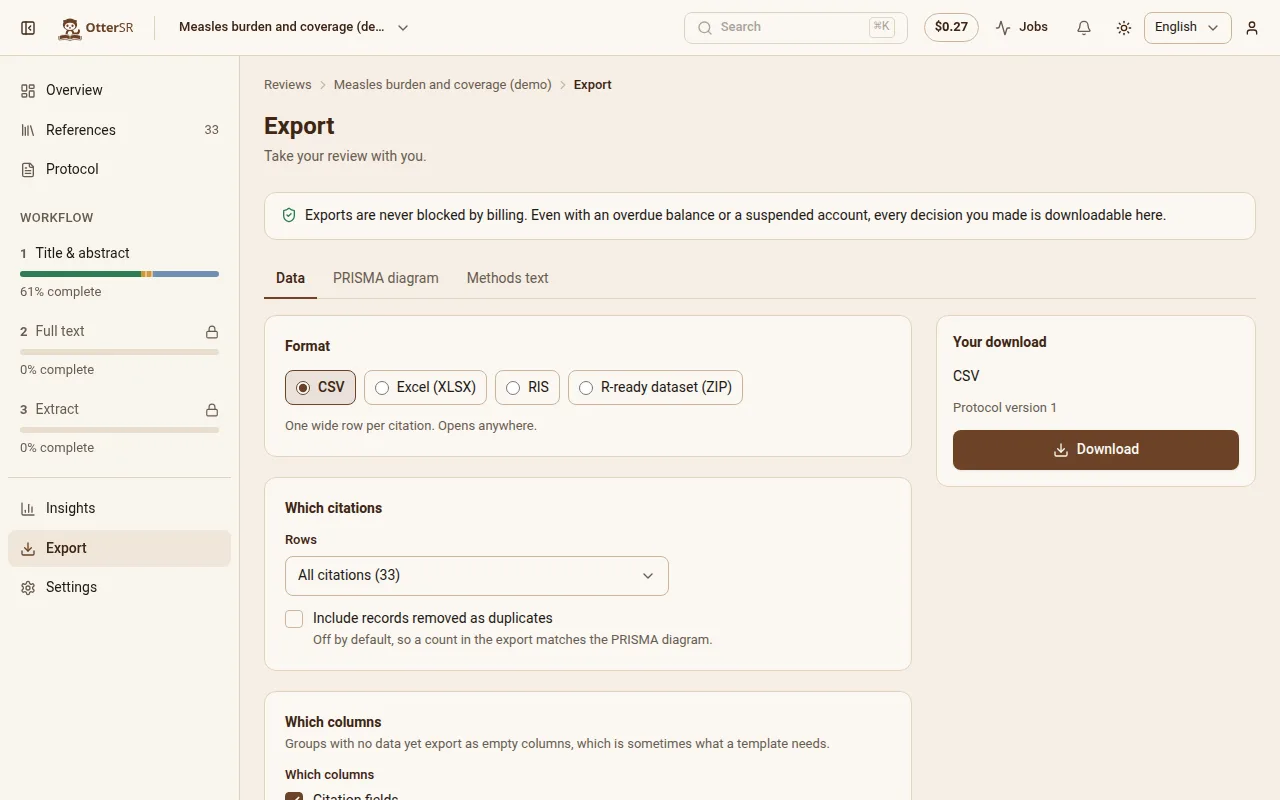
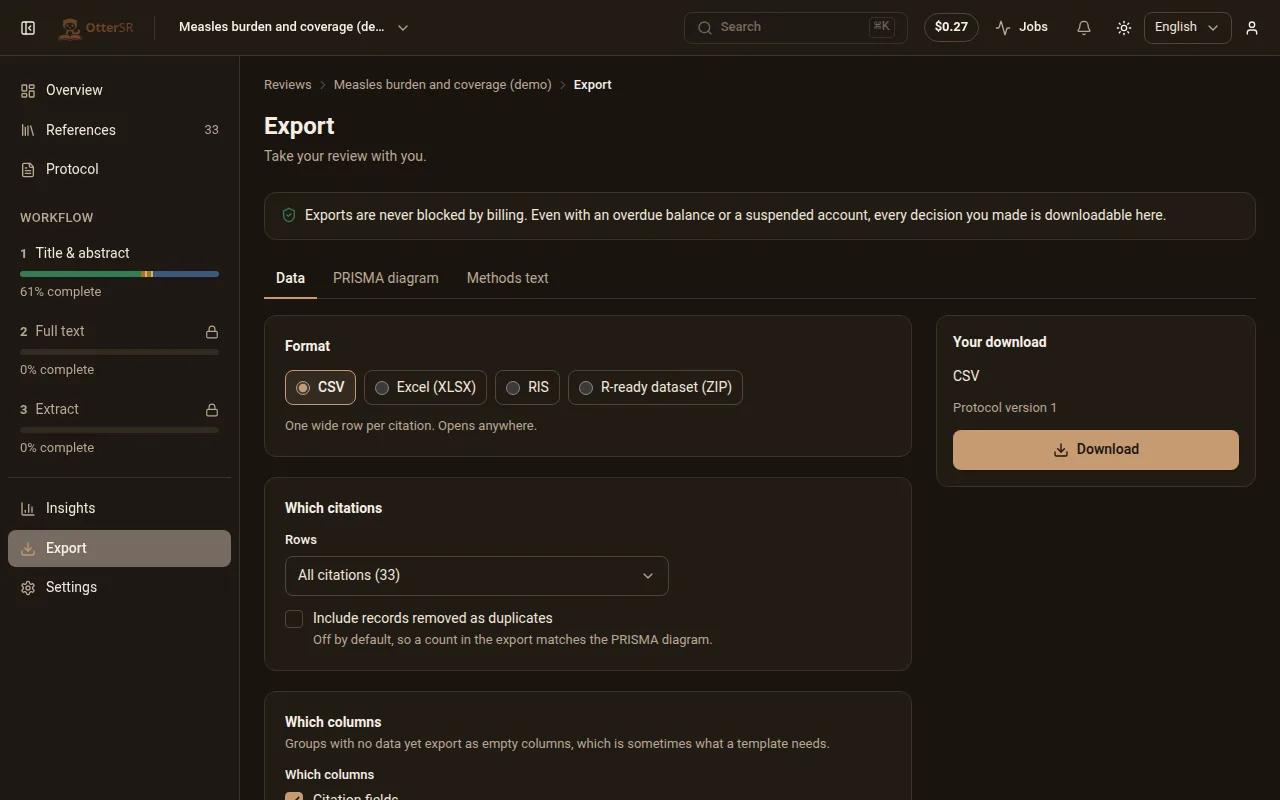
导出绝不会被阻止——付款逾期时不会,超出预算时不会,任何时候都不会。
撰写综述
让 AI 生成一张表格、一幅森林图、一张 PRISMA 流程图或一段结果段落。AI 会基于你提取的数据生成,引用你的研究,并逐字引述原文。数据无法支持的请求会被拒绝,绝不会凭空编造。
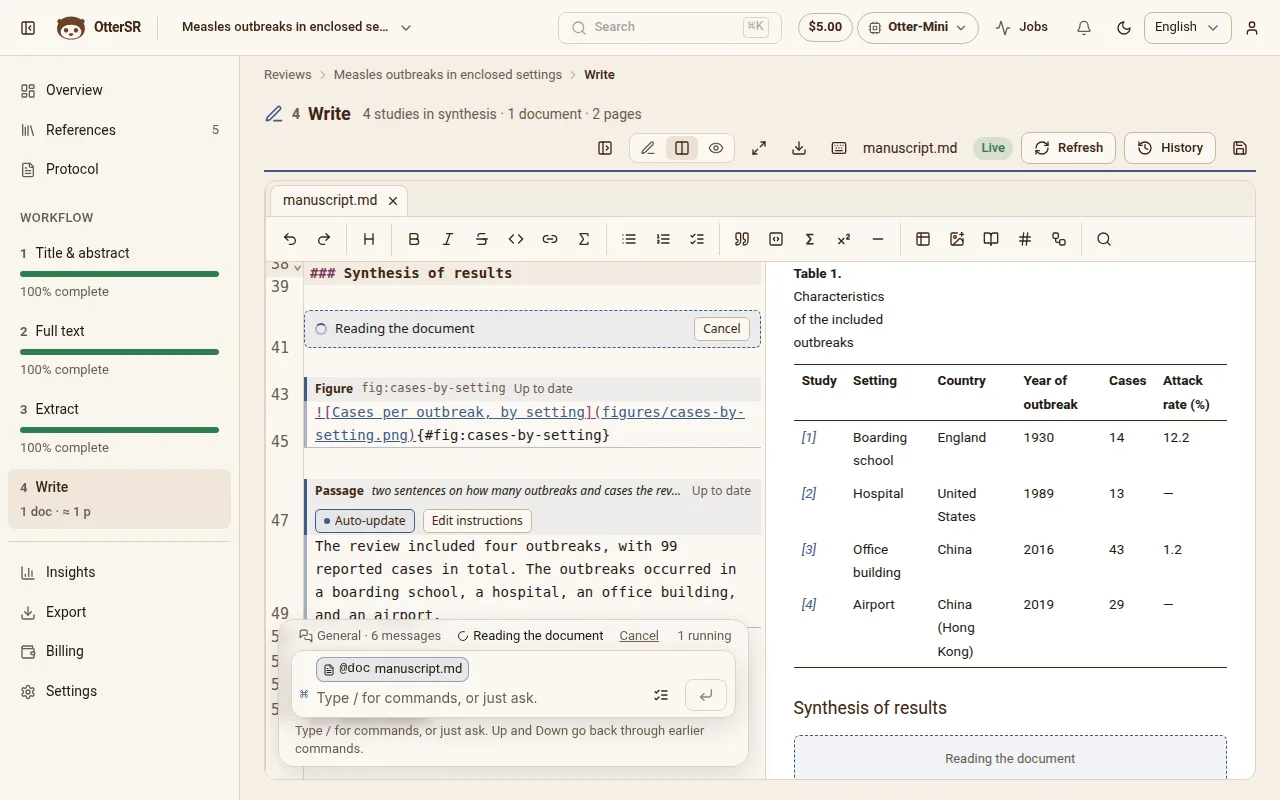
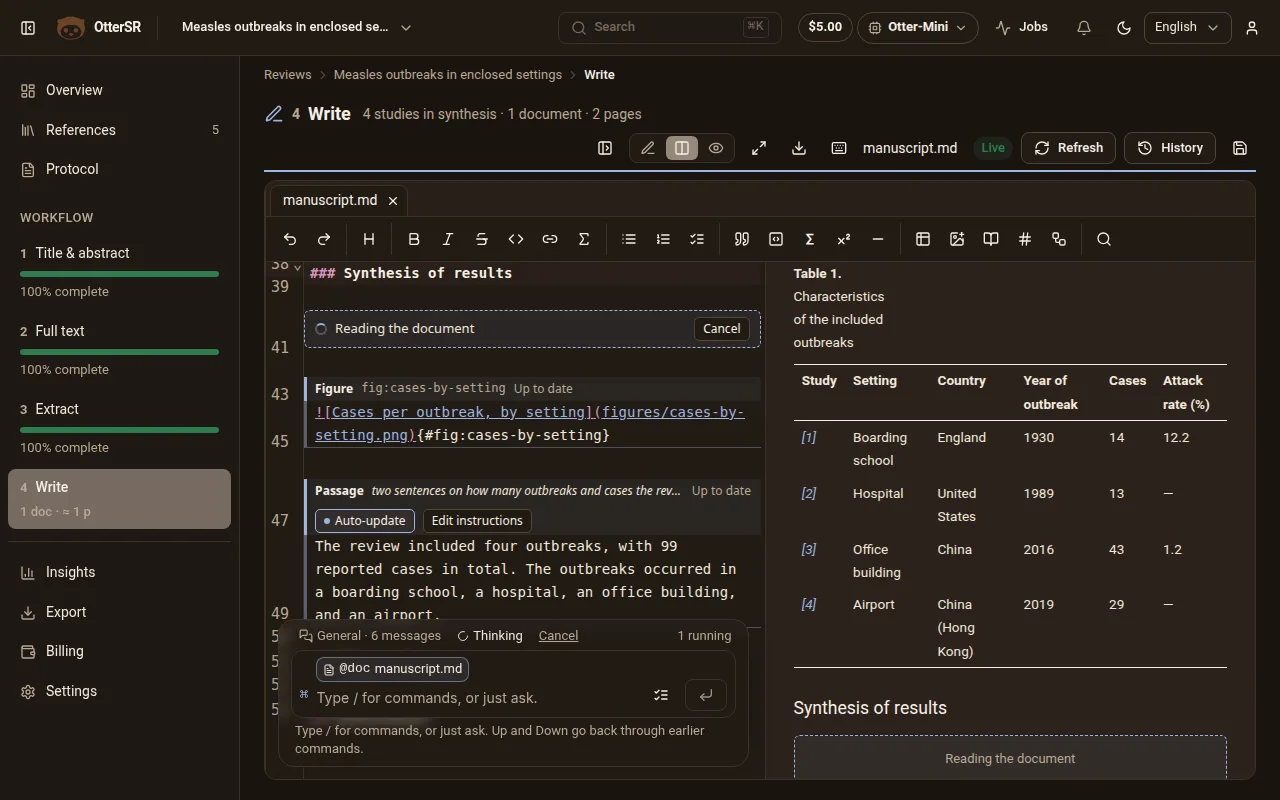
图和表始终与其数据关联,数据变化时会自动刷新。稿件可导出为 PDF。
在示例综述上试一试
一个现成的综述,包含标注清晰的演示文献和一份方案。在你下令之前不会筛选任何内容。